In meiner Vertiefungsarbeit am Centre for Artificial Intelligence der ZHAW habe ich untersucht, ob sich Kolmogorov-Arnold Networks (KANs) dazu eignen, die Parameter unseres Universums aus astronomischen Daten abzuleiten. Ausgangspunkt war eine Studie, die mit Deep Learning die Geschichte der kosmischen Reionisierung aus simulierten 21-cm-Signalen rekonstruiert2. Ich habe das Problem auf Weak Lensing übertragen und dabei statt einer etablierten Architektur die noch weitgehend ungetestete KAN-Architektur verwendet.
Hintergrund
Kolmogorov-Arnold Networks
Ein klassisches neuronales Netz (MLP) legt feste Aktivierungsfunktionen auf die Knoten und lernt nur die Gewichte dazwischen. Ein KAN dreht dieses Prinzip um: Auf jeder Kante sitzt eine lernbare Funktion, die Knoten summieren lediglich auf1. Der Wert des Knotens in Schicht ist damit
wobei jedes ein Spline mit trainierbaren Koeffizienten ist. Trainiert wird trotzdem ganz normal per Backpropagation. Der Vorteil liegt darin, dass sich ein trainiertes Netz direkt ablesen lässt, weil jede Kante eine einzelne, plotbare Kurve ist. Zudem lässt sich das Gitter der Splines nachträglich verfeinern, ohne das bereits Gelernte zu verwerfen.
Weak Gravitational Lensing
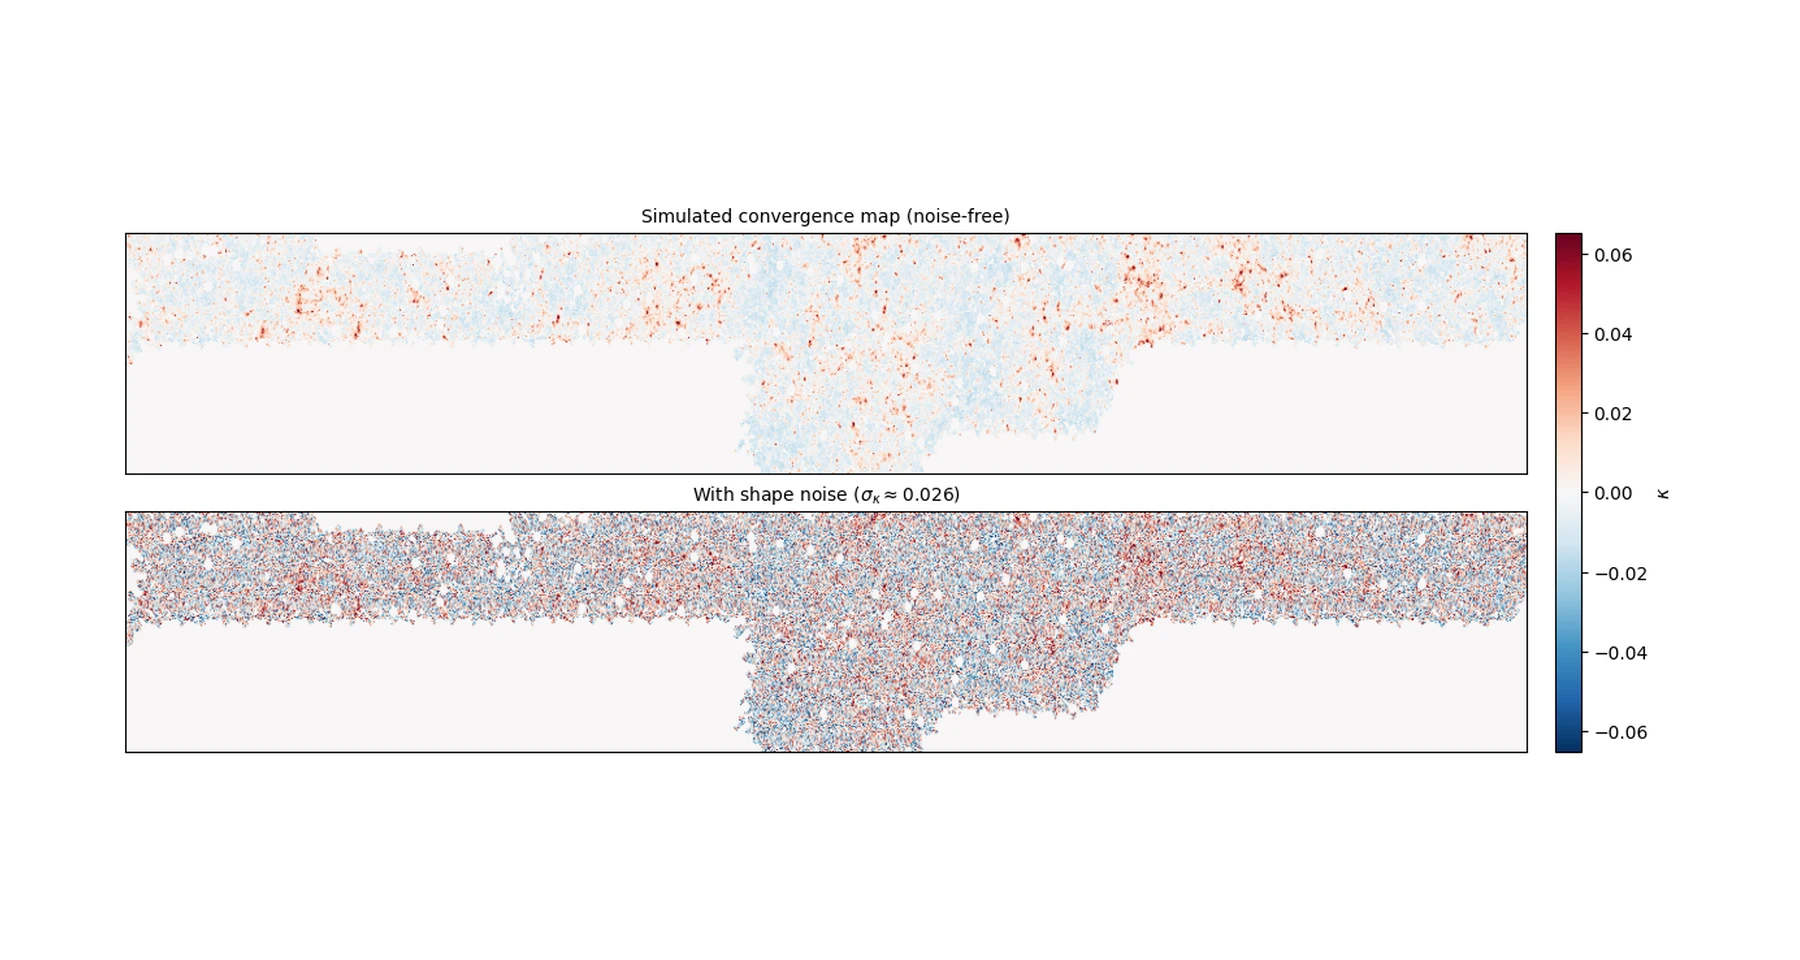
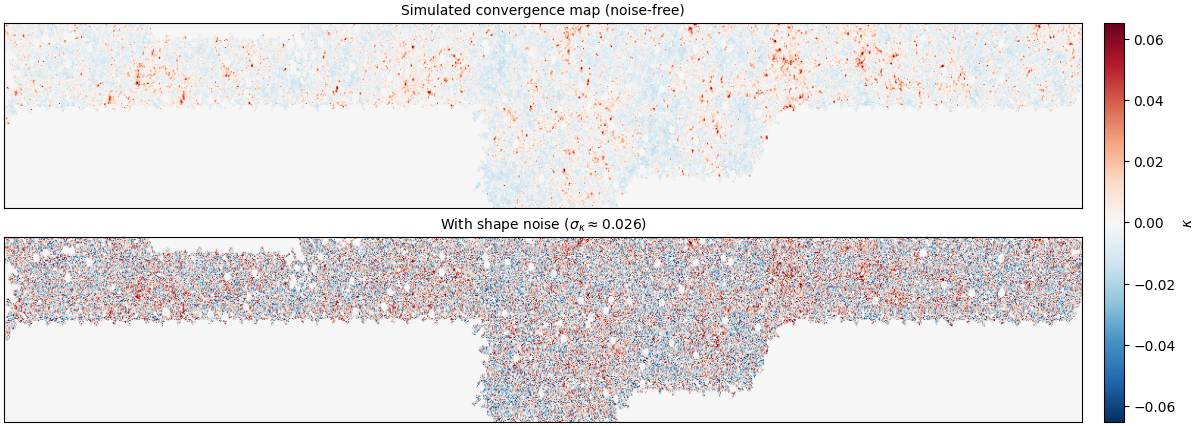
Licht ferner Galaxien wird auf dem Weg zu uns von Materie leicht abgelenkt, wodurch ihre Formen minimal verzerrt erscheinen3. Über viele Galaxien gemittelt ergibt das sogenannte Konvergenzkarten, zweidimensionale Bilder der projizierten Materiedichte. Aus ihnen sollen zwei kosmologische Parameter bestimmt werden: der Materiedichteparameter und die «Klumpigkeit» . Als Datengrundlage diente die Challenge von FAIR Universe4. Zusätzlich muss das Modell für jeden Parameter ein 68-Prozent-Konfidenzintervall angeben, denn ein Schätzwert ohne Unsicherheit ist in der Kosmologie wenig wert.
Vergleich der KAN-Varianten
Seit dem ursprünglichen Paper sind zahlreiche KAN-Varianten entstanden. Da deren Genauigkeits- und Geschwindigkeitsversprechen meist auf eigenen Benchmarks beruhen, bestand der Kern der Arbeit darin, sie unter gleichen Bedingungen zu vergleichen. Dazu habe ich ein reproduzierbares Experimentier-Framework mit PyTorch, Hydra, Optuna und MLflow aufgebaut, in dem jede Architektur mit eigener Hyperparameter-Suche abgestimmt wird. Der Code liegt in den Repositories kan-lab und kan-weak-lensing.
Verglichen wurden das Original PyKAN, EfficientKAN5, FastKAN6, FasterKAN7 und Wav-KAN8, die die Rechenweise oder die Basisfunktionen der Splines austauschen, sowie die strukturell anderen KKAN9 (konvolutional) und KAT10 (Transformer). Die Benchmarks wurden in drei Phasen mit steigender Komplexität durchgeführt: zuerst zehn analytische Funktionen, dann Bilddatensätze wie MNIST und schliesslich die Weak-Lensing-Karten.
Resultate
Über alle drei Phasen hinweg war EfficientKAN die einzige Variante, die stets an oder nahe der Spitze lag. Die als schneller beworbenen Varianten liefen zwar tatsächlich schneller, allerdings nur etwa doppelt so schnell statt der versprochenen drei- bis fünffachen Geschwindigkeit, und sie bezahlten dafür auf den analytischen Funktionen mit deutlich schlechterer Genauigkeit. KKAN und KAT kosteten fünf bis dreissig Mal mehr Trainingszeit, ohne dass sich ihr struktureller Vorteil in besserer Genauigkeit zeigte.
Auf den Weak-Lensing-Karten erreichten die vollständig verbundenen Varianten ein von 0.84 bis 0.86. Die beste Konfiguration, EfficientKAN mit direkt auf den Score trainierter Unsicherheit, erzielte einen Challenge-Score von 10.61. Das entspricht geschätzt Rang 27 von 63 der öffentlichen Bestenliste, also solidem Mittelfeld. Da die Test-Labels der Challenge nicht öffentlich sind, wurde auf einem internen Validierungs-Split gemessen, die Platzierung ist somit eine Schätzung und keine eingereichte Wertung.
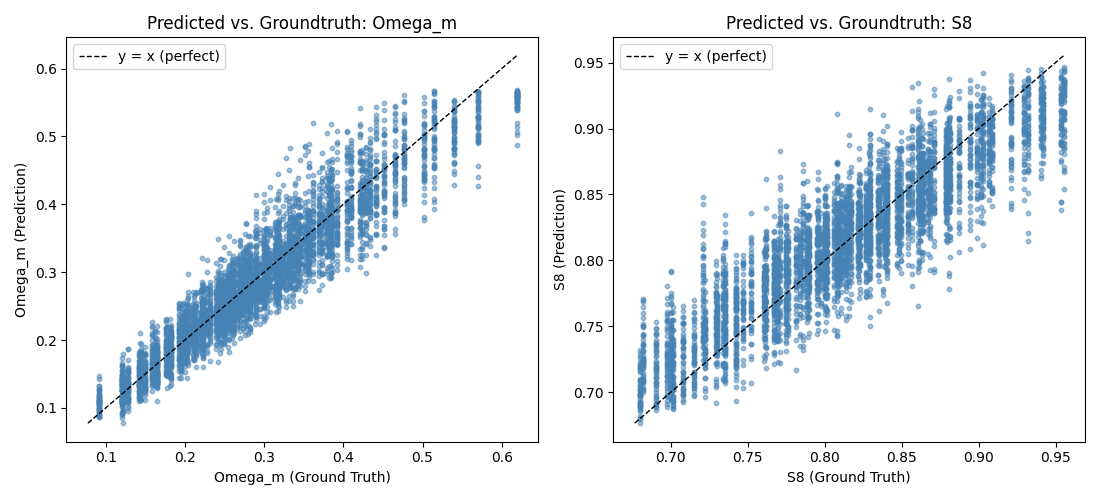
Interessant war die Kalibrierung der Unsicherheiten. Beim Training auf den mittleren quadratischen Fehler schätzen die Modelle ihre Unsicherheit über die Streuung eines Ensembles11. Drei Architekturen brachen dabei im Score stark ein. Vermutlich waren ihre Ensemble-Mitglieder zu ähnlich, wodurch die Unsicherheit zu klein ausfiel. Lernt das Modell die Unsicherheit stattdessen direkt über den Score, verschwindet dieses Problem.
Erweiterung von EfficientKAN
EfficientKAN ist schnell, weil es auf zwei Fähigkeiten des Originals verzichtet: die nachträgliche Gitterverfeinerung und die Vereinfachungs-Pipeline. Beide habe ich im Repository efficient-kan-plus wiederhergestellt, ohne den schnellen Standard-Forward-Pass zu verlangsamen.
Gitter-Erweiterung
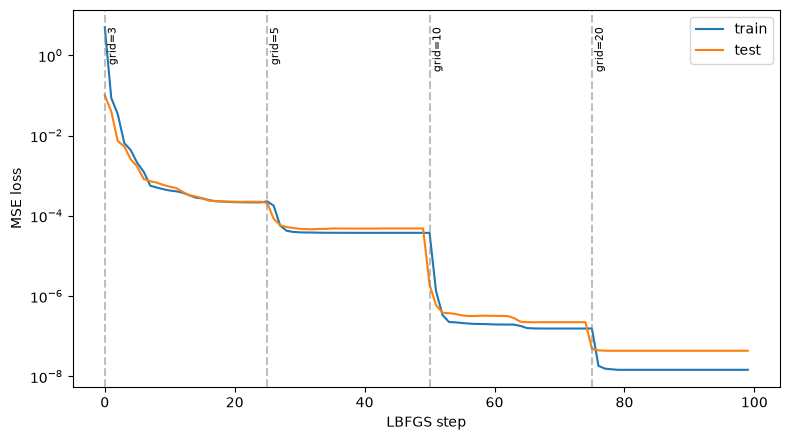
Beim Verfeinern wird das Spline-Gitter jeder Kante per Least Squares auf ein feineres Gitter übertragen, sodass die gelernte Funktion exakt erhalten bleibt. Der Fehler fällt danach nicht mehr von vorn, sondern stufenweise weiter ab: Bei einem kleinen Netz sank der Test-MSE beim Verfeinern von Gitter 3 auf 20 von auf .
Vereinfachung zur Formel
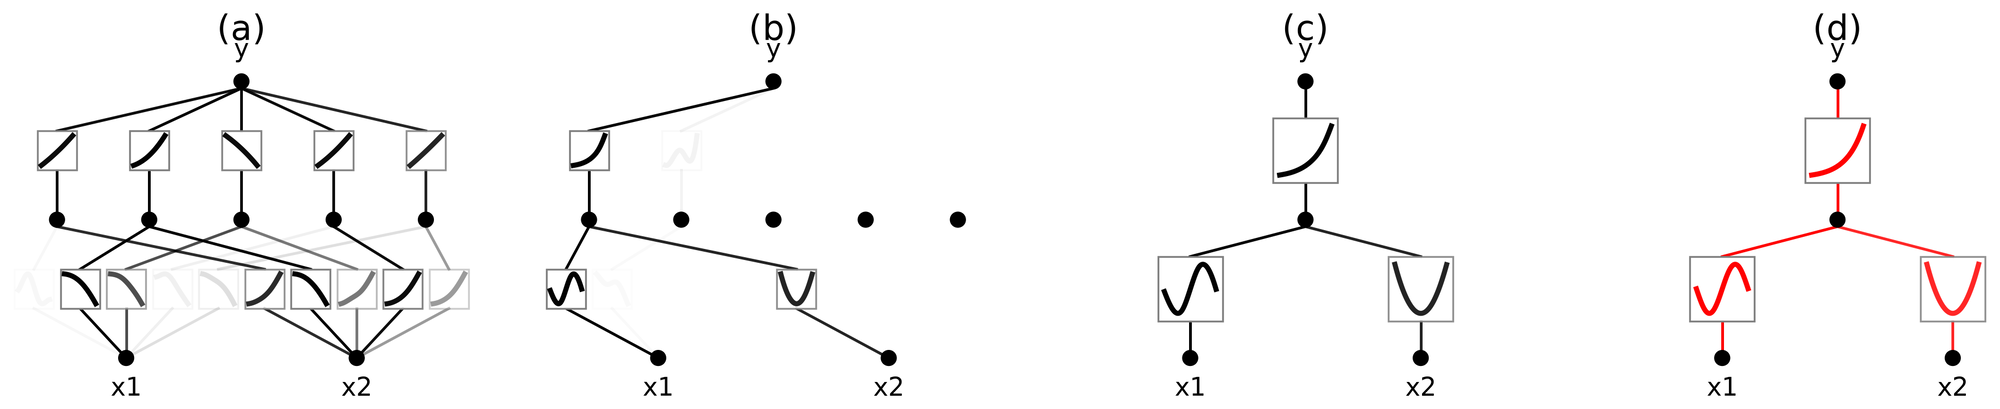
Die Pipeline reduziert ein trainiertes KAN in vier Schritten auf einen lesbaren Ausdruck: Sparsifizierung, Pruning, das Ersetzen der Kantenfunktionen durch bekannte Funktionen und das Extrahieren der Formel. Am Beispiel schrumpft das Netz von fünf auf einen einzigen versteckten Knoten, und die rekonstruierte Formel stimmt (mit zusammengefassten Konstanten) bis auf kleine Abweichungen mit der Vorgabe überein:
Fazit
KANs sind auf dem Weak-Lensing-Problem konkurrenzfähig, aber noch nicht klar überlegen: Mit einem Score im Mittelfeld liegen sie hinter den Gewinnern der Challenge. Ihre Stärke liegt in der transparenteren Struktur, auch wenn die Formel-Extraktion bisher nur an einem einfachen Beispiel gezeigt wurde und nicht an den eigentlichen Modellen. Das wäre der nächste Schritt, zusammen mit einem Ersatz der Ensembles durch simulationsbasierte Inferenz.
Quellen
- [1] Liu et al.: KAN: Kolmogorov-Arnold Networks
- [2] De Salis et al.: Exploring the Early Universe with Deep Learning
- [3] Bartelmann & Schneider: Weak Gravitational Lensing
- [4] FAIR Universe: Weak Lensing ML Uncertainty Challenge
- [5] Cao: efficient-kan (EfficientKAN)
- [6] Li: Kolmogorov-Arnold Networks are Radial Basis Function Networks (FastKAN)
- [7] Delis: faster-kan (FasterKAN)
- [8] Bozorgasl & Chen: Wav-KAN: Wavelet Kolmogorov-Arnold Networks
- [9] Bodner et al.: Convolutional Kolmogorov-Arnold Networks (KKAN)
- [10] Yang & Wang: Kolmogorov-Arnold Transformer (KAT)
- [11] Lakshminarayanan et al.: Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles