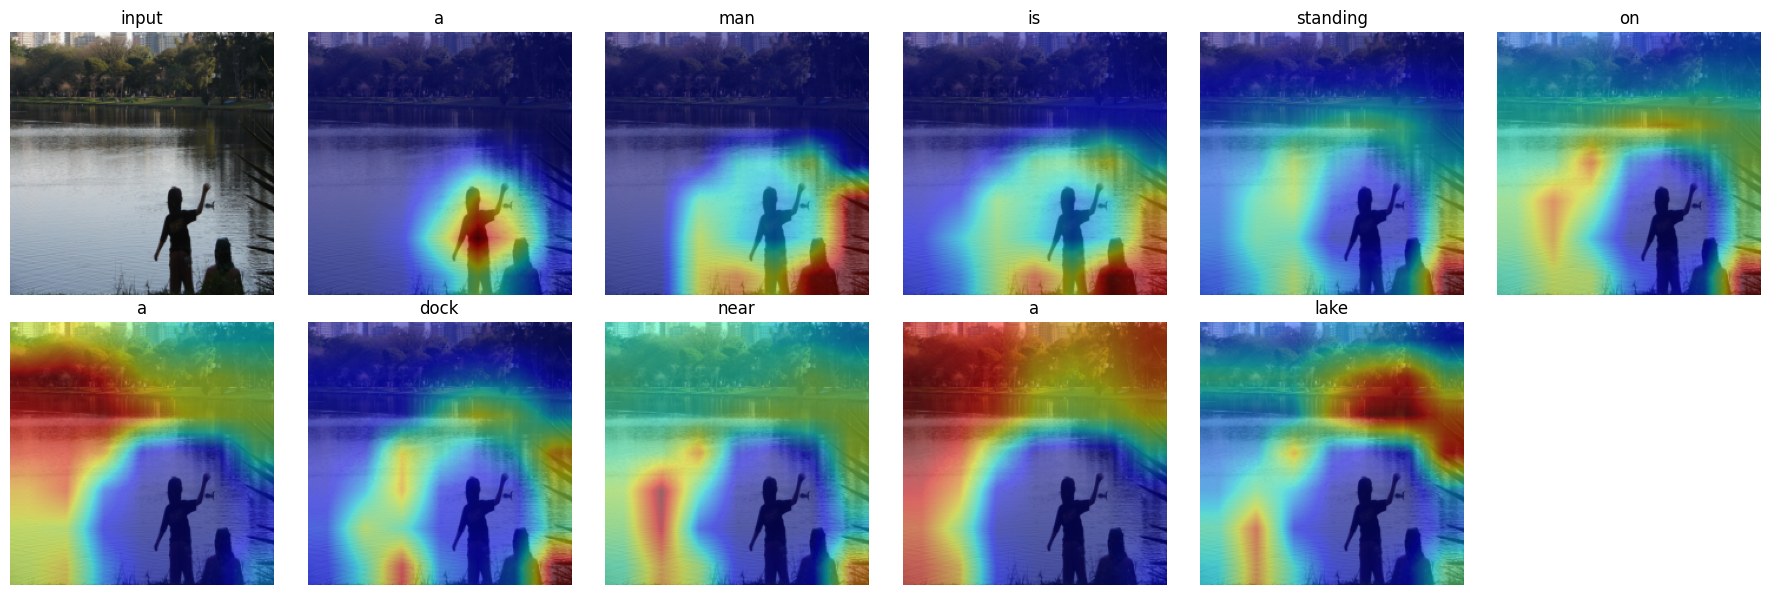
Für ein Modul zu Deep Learning an der ZHAW habe ich mich als Übungsaufgabe damit beschäftigt, wie ein Modell zu einem Foto selbstständig einen passenden Satz in natürlicher Sprache generiert, ähnlich der automatischen Bildbeschreibung, wie man sie etwa von Google Fotos kennt. Verlangt war die Implementierung und der Vergleich von zwei unterschiedlichen Architekturen unter identischen Bedingungen, ergänzt um eigene Erweiterungen.
Zwei Architekturen im Vergleich
Beide Modelle folgen dem Encoder-Decoder-Prinzip und verwenden denselben eingefrorenen, auf ImageNet vortrainierten ResNet18 als Bild-Encoder1. Statt des üblichen Klassifikationskopfs wird nur die letzte Feature-Map von 512 Kanälen bei 7×7 Positionen verwendet. Das Einfrieren des Encoders hält die Anzahl trainierbarer Parameter klein und beugt Overfitting auf dem vergleichsweise kleinen Datensatz vor.
Show and Tell
Das einfachere Modell mittelt die 49 räumlichen Positionen zu einem einzelnen 512-dimensionalen Vektor, projiziert diesen auf 256 Dimensionen und übergibt ihn als erstes Eingabe-Token an ein LSTM2. Von dort an generiert das LSTM die Bildbeschreibung Wort für Wort.
Show, Attend and Tell
Das zweite Modell behält die volle 7×7-Feature-Map und ergänzt einen additiven Attention-Mechanismus3: Bei jedem Dekodierschritt berechnet dieser aus dem aktuellen LSTM-Zustand ein Gewicht für jede der Bildregionen und bildet daraus einen gewichteten Kontextvektor :
Die Rohwerte stammen dabei aus einem kleinen neuronalen Netz, das den aktuellen Zustand mit jeder Bildregion vergleicht. Die Softmax-Normalisierung sorgt dafür, dass sich die Gewichte zu aufsummieren, ähnlich einer Verteilung der Aufmerksamkeit über das Bild. So kann sich das Modell bei jedem Wort erneut auf die dafür relevanten Bildbereiche konzentrieren, statt sich auf einen einzigen, bereits gemittelten Vektor zu verlassen.
Daten und Training
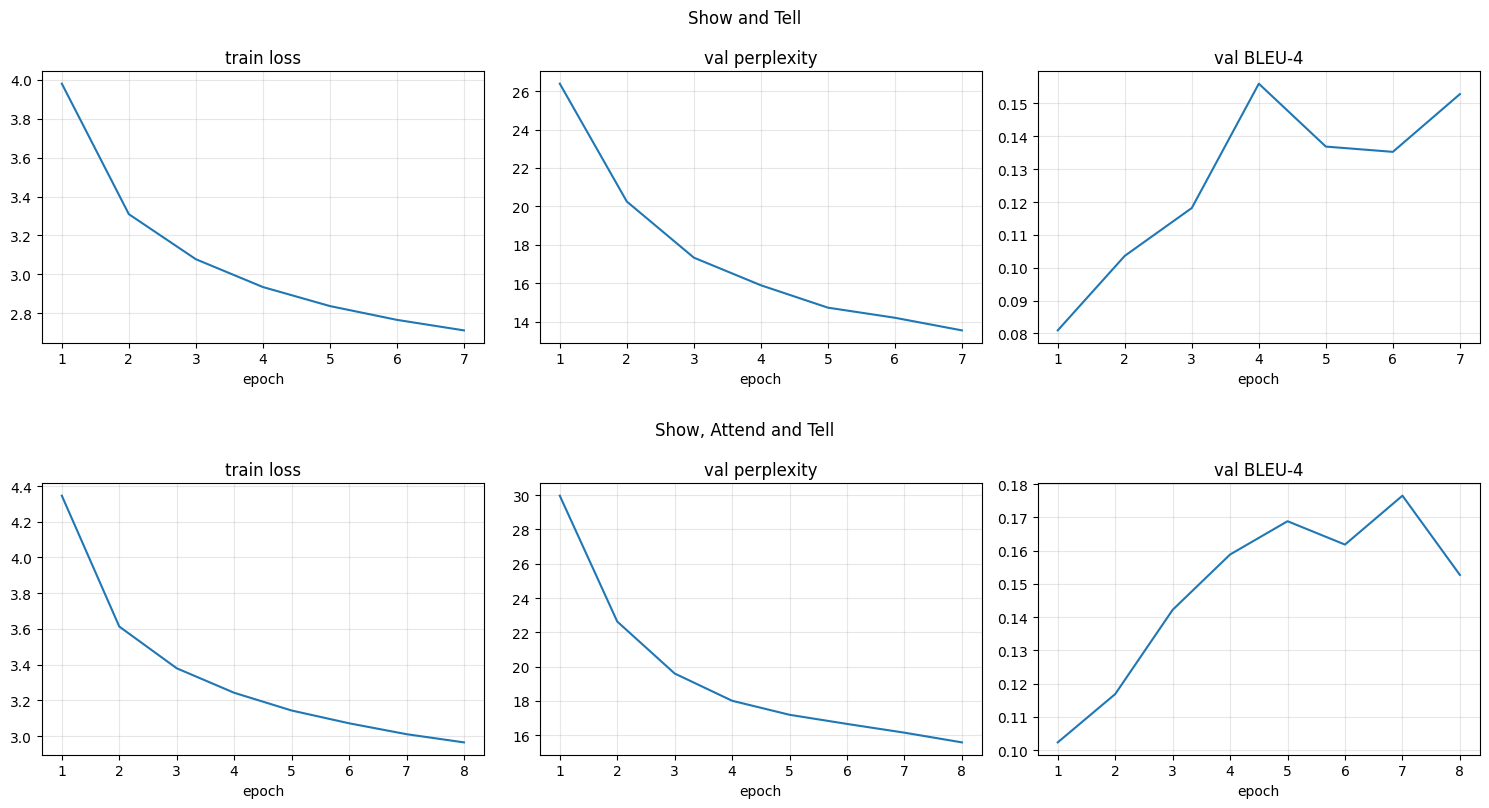
Als Datengrundlage diente der Flickr8k-Datensatz mit rund 6’500 Trainingsbildern und je fünf menschlichen Referenzbeschreibungen pro Bild, was nach der Vorverarbeitung 32’365 Bild-Text-Paare ergibt. Der Wortschatz wurde ausschliesslich aus den Trainingsdaten aufgebaut, um jegliches Data Leakage zu vermeiden, und umfasst 2’649 Tokens. Trainiert wurde mit Adam, einer Lernrate von 4e-4, Batch-Grösse 64 und bis zu 8 Epochen, abgesichert durch Dropout, Gradient Clipping und Early Stopping auf Basis von BLEU-4 mit einer Geduld von drei Epochen.
Ergebnisse
Zur Bewertung dient neben BLEU auch die Perplexität, welche misst, wie überrascht das Modell im Schnitt von den tatsächlichen Referenzwörtern ist:
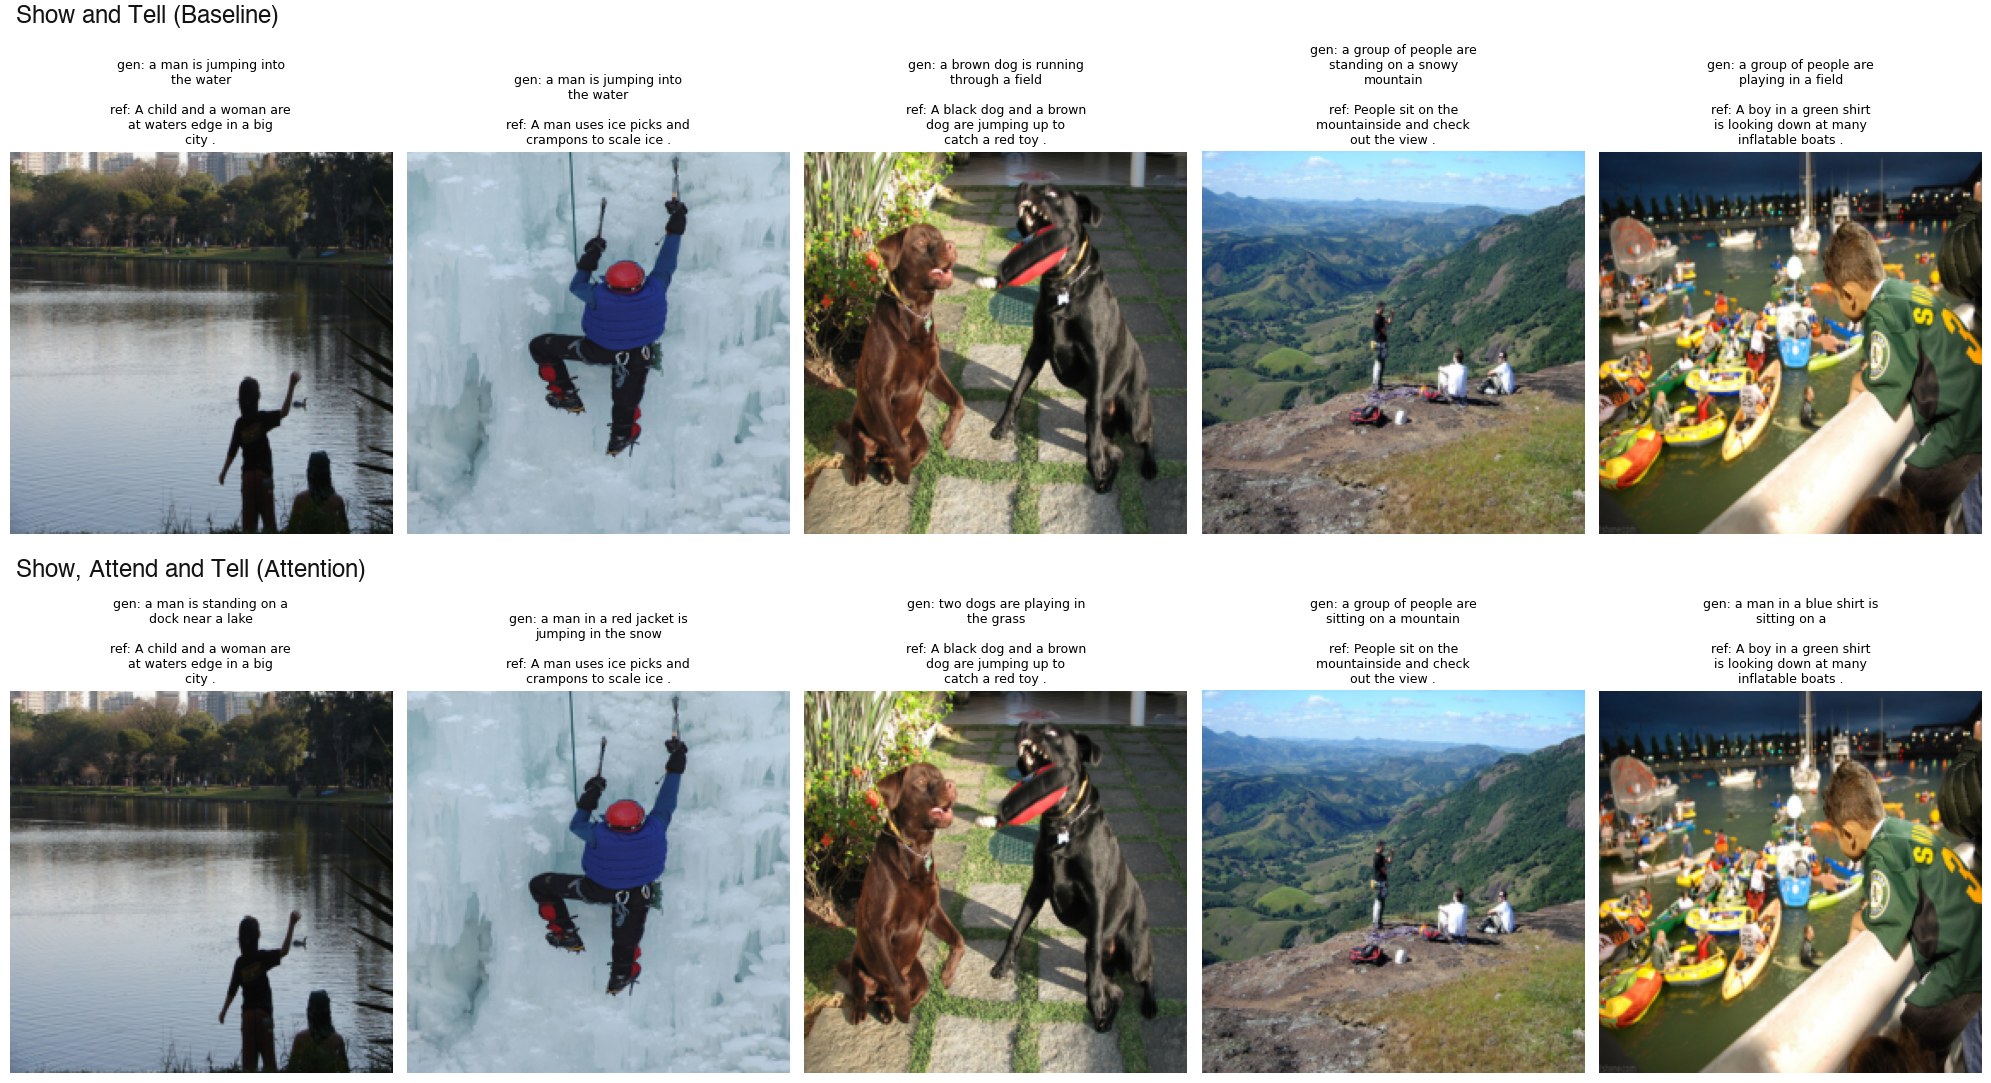
Eine tiefere Perplexität bedeutet, dass das Modell den nächsten Wörtern im Schnitt eine höhere Wahrscheinlichkeit zuweist. Auf dem Testset erreicht das Attention-Modell mit einer Perplexität von 17.04 und einem BLEU-4-Wert von 0.180 bessere BLEU-Werte als das einfachere Show-and-Tell-Modell mit 16.57 Perplexität und 0.152 BLEU-44. Der Vorsprung fällt besonders bei den höhergradigen BLEU-Metriken ins Gewicht, welche zusammenhängende Wortfolgen statt einzelner Wörter bewerten, was zur Erwartung passt, dass gezielte Aufmerksamkeit auf einzelne Bildregionen zu kohärenteren Formulierungen führt.
Attention-Visualisierung
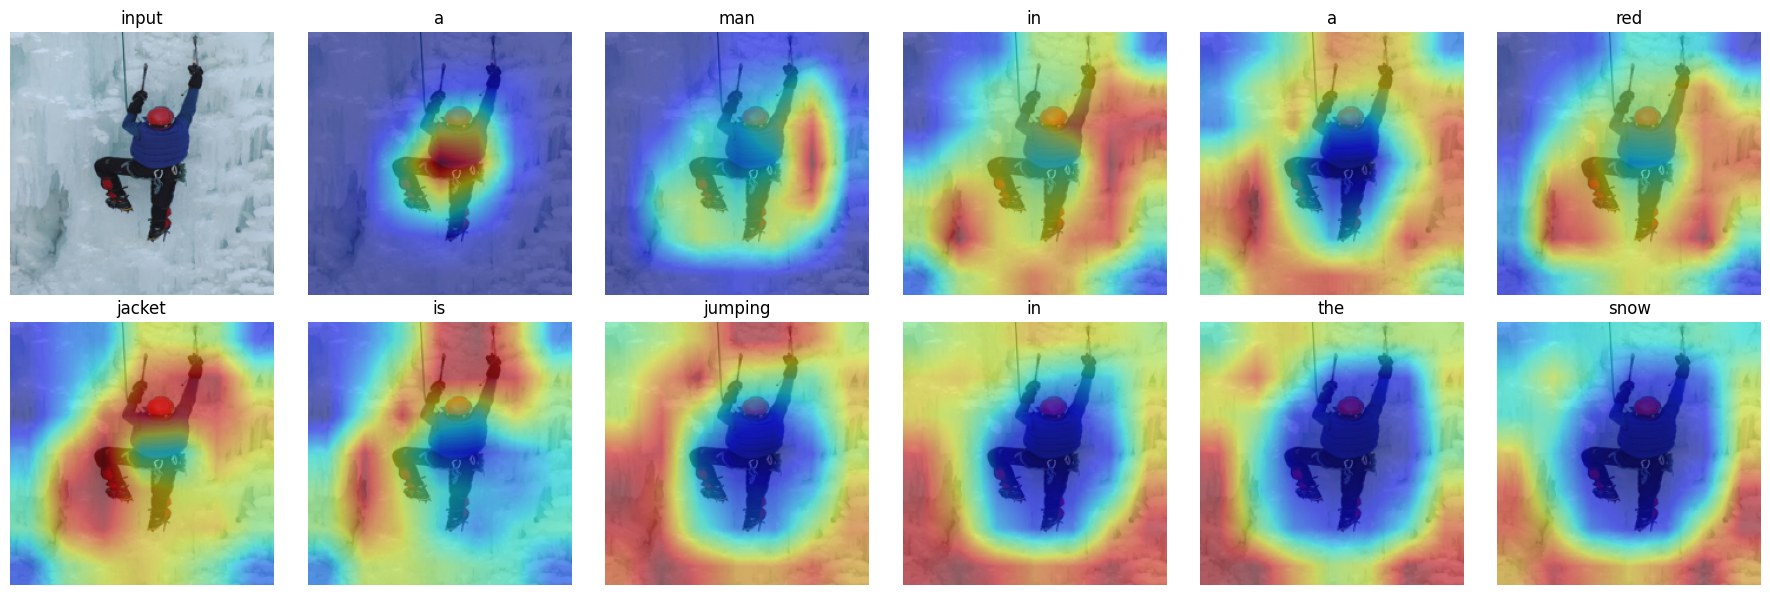
Um den Attention-Mechanismus sichtbar zu machen, habe ich die 7×7-Gewichtungskarte für jedes generierte Wort auf die ursprüngliche Bildgrösse hochskaliert und über das Bild gelegt. Bei konkreten Substantiven konzentriert sich die Aufmerksamkeit meist klar auf die passende Bildregion, bei Füllwörtern wie “in” oder “the” verteilt sie sich dagegen deutlich diffuser über das Bild.
Beam Search
Als Erweiterung habe ich beim Attention-Modell die greedy Dekodierung mit Beam Search (Beam-Grösse 3, längennormalisiert) verglichen. Beam Search verbessert die höhergradigen BLEU-Werte leicht und konsistent (BLEU-4 von 0.180 auf 0.192) und liefert bei manchen Bildern etwas detailliertere Beschreibungen, allerdings auf Kosten einer spürbar langsameren Inferenz.
Grenzen und Ausblick
Flickr8k ist ein kleiner Datensatz, weshalb die absoluten Werte bescheiden ausfallen und die Modelle bei ungewöhnlichen Szenen zu generischen oder gelegentlich halluzinierten Beschreibungen neigen. Der eingefrorene Encoder limitiert zudem, wie gut sich die visuellen Merkmale an die eigentliche Aufgabe anpassen können, und BLEU misst nur Wortüberlappung mit den Referenzen, was mit menschlicher Qualitätswahrnehmung nur schwach korreliert. Für eine Weiterentwicklung würden sich das Feintunen der oberen Encoder-Schichten, vortrainierte Wort-Embeddings, ein Transformer-Decoder oder zusätzliche Metriken wie CIDEr oder METEOR anbieten. Für eine Übungsarbeit zeigen die Resultate aber bereits deutlich, dass räumliche Aufmerksamkeit die Qualität generierter Bildbeschreibungen gegenüber dem einfacheren CNN-LSTM-Ansatz spürbar verbessert.
Quellen
- [1] He et al.: Deep Residual Learning for Image Recognition (ResNet)
- [2] Vinyals et al.: Show and Tell: A Neural Image Caption Generator
- [3] Xu et al.: Show, Attend and Tell: Neural Image Caption Generation with Visual Attention
- [4] Papineni et al.: BLEU: a Method for Automatic Evaluation of Machine Translation