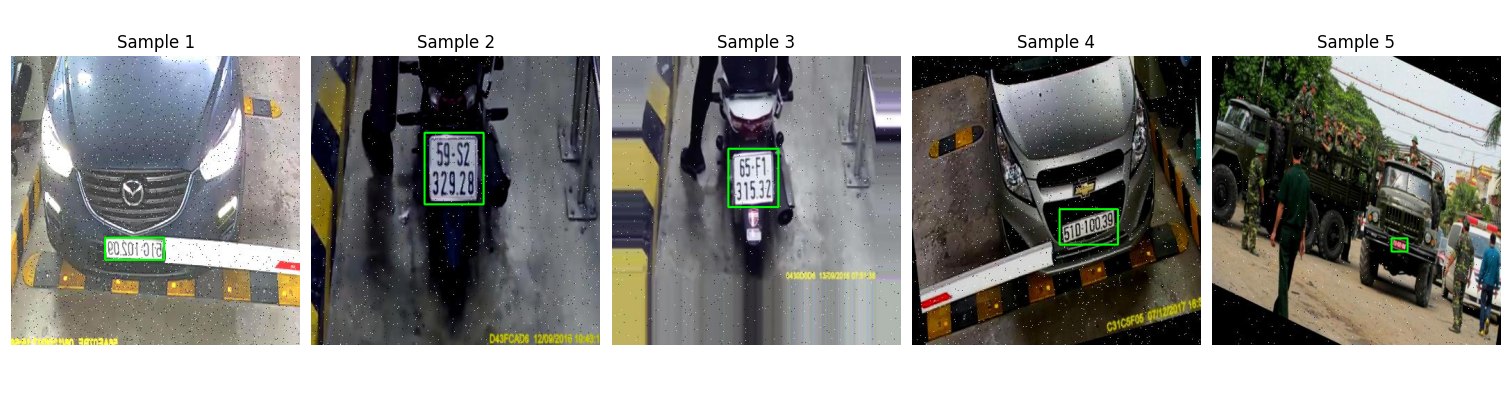
Für ein Modul zu Computer Vision habe ich als Übungsaufgabe eine kleine Pipeline gebaut, die Kontrollschilder auf Fotos automatisch erkennt und durch künstlich erzeugte, nicht mehr lesbare Kennzeichen ersetzt, ähnlich wie Gesichter oder Kennzeichen, die auf Strassenfotos unkenntlich gemacht werden. Die Aufgabe war in fünf Teilschritte gegliedert, von der reinen Erkennung bis zum realistischen Ersetzen der Kennzeichen. Es handelt sich dabei ausdrücklich um eine Übungsarbeit und keinen fertigen Produktionscode, trotzdem funktioniert die Grundidee bereits erstaunlich gut.
Kennzeichen erkennen
Als Grundlage für die Erkennung habe ich kein eigenes Modell trainiert, sondern ein bereits feingetuntes YOLOv11-Modell von Hugging Face verwendet, das gezielt auf die Erkennung von Kennzeichen spezialisiert ist, wie im Bild oben zu sehen. Objekterkennungsmodelle wie YOLO sagen für ein Bild sowohl die Position als auch die Klasse von Objekten voraus, in diesem Fall also achsenparallele Bounding Boxes rund um jedes gefundene Kennzeichen. Als Datengrundlage diente ein Kaggle-Datensatz mit mehreren tausend Fahrzeugbildern.
Orientierung bestimmen und zuschneiden
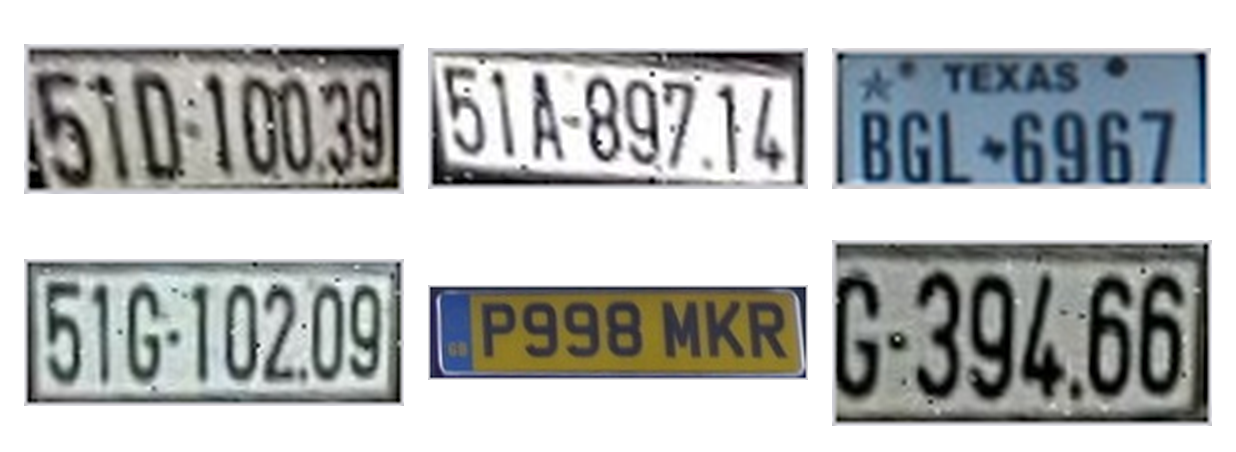
Die Bounding Box aus dem ersten Schritt ist achsenparallel und schliesst bei schräg fotografierten Kennzeichen oft unnötig viel Hintergrund mit ein. Um die exakte Ausrichtung zu bestimmen, habe ich bewusst auf klassische Bildverarbeitung statt auf ein weiteres Deep-Learning-Modell gesetzt: Im Ausschnitt der Bounding Box wird zuerst mit dem Canny-Algorithmus die Kantenkarte berechnet3, anschliessend werden über die Hough-Transformation die vier dominantesten Geraden gefunden, welche die Ränder des Kennzeichens bilden4. Jede Gerade wird dabei nicht mit Steigung und Achsenabschnitt beschrieben, sondern über ihren Normalenabstand zum Ursprung und den Winkel dieser Normalen:
Diese Parametrisierung erlaubt es auch, senkrechte Kanten ohne Sonderfall zu erfassen. Aus den Schnittpunkten der vier gefundenen Geraden ergeben sich die vier Eckpunkte des Kennzeichens, mit denen sich über eine perspektivische Transformation ein sauber ausgerichteter, entzerrter Ausschnitt erzeugen lässt.
Neue Kennzeichen generieren
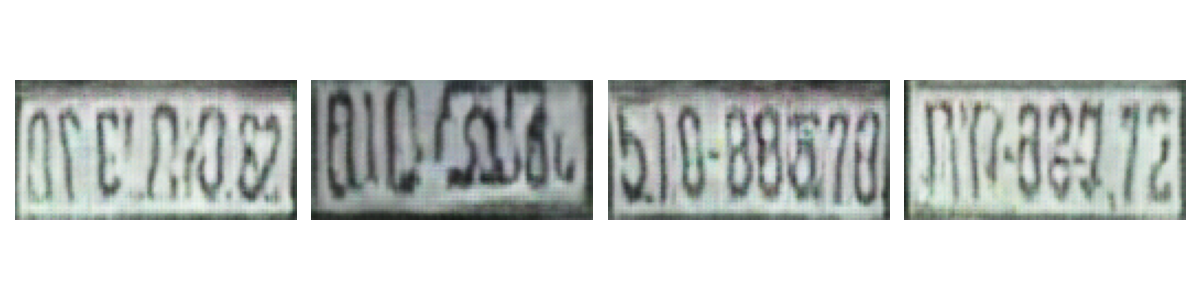
Für den nächsten Schritt sollten neue, künstliche Kennzeichen generiert werden, welche später die echten ersetzen. Dazu habe ich ein eigenes Generative Adversarial Network trainiert1: Ein Generator versucht aus zufälligem Rauschen plausible Kennzeichen-Bilder zu erzeugen, während ein Diskriminator gleichzeitig lernt, diese von echten, zuvor zugeschnittenen Kennzeichen zu unterscheiden. Beide Netzwerke werden dabei über dasselbe gegensätzliche Ziel trainiert:
Der Diskriminator versucht diesen Ausdruck zu maximieren, indem er echte Bilder als echt und generierte als gefälscht erkennt, während der Generator ihn zu minimieren versucht, indem er den Diskriminator möglichst gut täuscht. Architektonisch orientiert sich mein Generator und Diskriminator an einem DCGAN mit transponierten beziehungsweise gewöhnlichen Convolutions, Batch-Normalization und einem 64-dimensionalen latenten Vektor als Eingabe2. Trainiert wurde das Netz für 150 Epochen auf den zuvor zugeschnittenen Kennzeichen.
Kennzeichen ersetzen
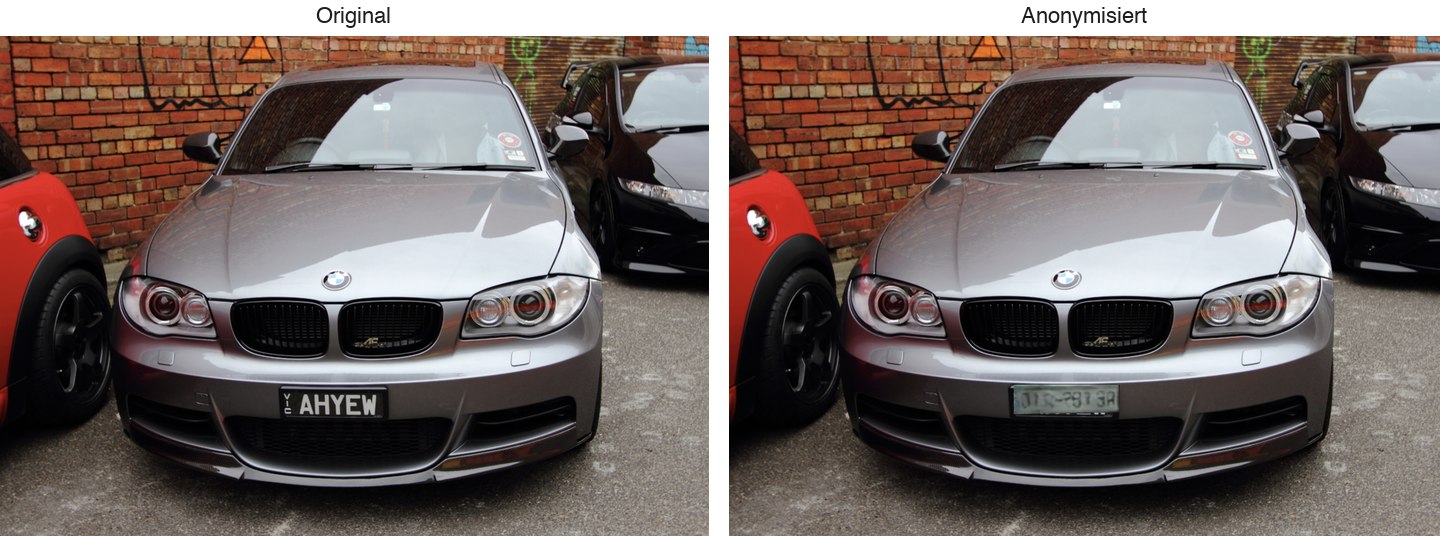
Im letzten Schritt werden Erkennung, Zuschnitt und Generierung zusammengeführt: Für jedes erkannte Kennzeichen generiert das GAN eine neue Bildprobe, die anschliessend perspektivisch auf die exakte Form und Grösse des Original-Kennzeichens verzerrt und über eine Maske ins Ursprungsbild eingesetzt wird. So bleibt die Position im Bild erhalten, nur der Inhalt des Kennzeichens ändert sich.
Grenzen und Ausblick
Als Übungsaufgabe hatte diese Pipeline nie den Anspruch, produktionsreif zu sein: Das GAN erzeugt keine scharfen, individuellen Zeichen, sondern eher plausibel wirkende Muster, und auch die Einpassung ist rein geometrisch, ohne Beleuchtung, Schatten oder Bildrauschen des Originals zu berücksichtigen. Um die generierten Kennzeichen wirklich an die Aufnahmebedingungen anzupassen, würde sich ein Style-Transfer-Ansatz anbieten, der Farbgebung und Textur des Zielbilds auf das generierte Kennzeichen überträgt5. Für eine Übungsaufgabe zeigt das Ergebnis aber bereits deutlich, dass sich die Grundidee, Kennzeichen automatisiert zu erkennen und realistisch zu anonymisieren, mit vertretbarem Aufwand umsetzen lässt.
Quellen
- [1] Goodfellow et al.: Generative Adversarial Networks
- [2] Radford, Metz & Chintala: Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks (DCGAN)
- [3] Canny: A Computational Approach to Edge Detection
- [4] Duda & Hart: Use of the Hough Transformation to Detect Lines and Curves in Pictures
- [5] Johnson, Alahi & Fei-Fei: Perceptual Losses for Real-Time Style Transfer and Super-Resolution