Für meine Bachelorarbeit an der ZHAW habe ich zusammen mit einem Studienkollegen ein System entwickelt, das Suchanfragen nicht mehr nach exakten Wörtern, sondern nach ihrer Bedeutung beantwortet: Man findet also auch dann das Richtige, wenn man nicht genau die im Dokument verwendeten Begriffe eintippt. Wir haben dieses System konzipiert, prototypisch umgesetzt und anschliessend sowohl technisch als auch mit echten Nutzenden getestet.
Wie funktioniert eine semantische Suche
Eine klassische Stichwortsuche vergleicht nur Zeichenketten und scheitert deshalb oft an Schreibfehlern, Synonymen oder unterschiedlicher Terminologie. Eine semantische Suche löst dieses Problem, indem sie nicht mehr nach exakten Begriffen, sondern nach der Bedeutung eines Textes sucht.
Von Text zu Vektor
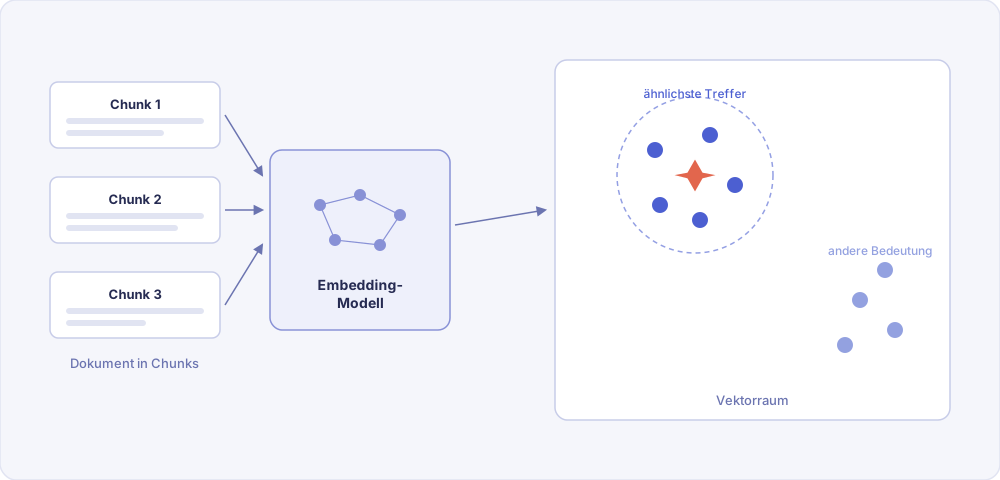
Möglich wird das durch Text-Embeddings: Ein Embedding-Modell wandelt einen Text in einen Vektor um, also eine Liste von einigen hundert bis mehreren tausend Zahlen, welche die Bedeutung des Textes im sogenannten Vektorraum kodieren1. Inhaltlich ähnliche Texte landen dabei nahe beieinander, unabhängig davon, mit welchen Wörtern sie formuliert sind. Wie nahe zwei Vektoren beieinanderliegen, lässt sich über Distanzfunktionen wie die Kosinus-Distanz oder das Skalarprodukt berechnen. Am gebräuchlichsten ist die Kosinus-Ähnlichkeit, welche den Winkel zwischen zwei Vektoren und bewertet, unabhängig von deren Länge:
Der Wert liegt zwischen und , wobei bedeutet, dass beide Vektoren exakt in dieselbe Richtung zeigen und damit inhaltlich am ähnlichsten sind.
Chunking
Damit auch lange Dokumente sinnvoll durchsucht werden können, werden sie vor dem Einbetten in kleinere Abschnitte aufgeteilt, sogenannte Chunks3. Ein Embedding pro ganzem Dokument würde dessen Bedeutung zu stark verwässern, ein Embedding pro Chunk bleibt dagegen präzise genug, um gezielt auf den relevanten Abschnitt zu verweisen. Wie ein Text am besten aufgeteilt wird, unterscheidet sich je nach Strategie: von fixer Grösse über rekursives Chunking bis hin zu satz- oder LLM-basierten Ansätzen. Anhand einer vergleichenden Auswertung verschiedener Chunking-Strategien4 haben wir uns für rekursives Chunking mit einer Grösse von 400 Tokens ohne Überlappung entschieden, da dieser Ansatz einen guten Kompromiss zwischen Trefferqualität und Rechenaufwand bietet.
Ähnlichkeitssuche in der Vektordatenbank
Die entstehenden Vektoren landen zusammen mit Metadaten in einer Vektordatenbank2. Sucht eine Person, wird die Anfrage nach demselben Prinzip in einen Vektor überführt. Statt diesen mit jedem gespeicherten Vektor einzeln zu vergleichen, was bei grossen Datenmengen zu langsam wäre, nutzt die Datenbank sogenannte Approximate-Nearest-Neighbour-Algorithmen, um effizient die ähnlichsten Vektoren zu finden. Zusätzlich lassen sich Metadaten wie Zugriffsrechte oder Änderungsdatum direkt in die Anfrage einbinden, wodurch sich die Suche gezielt filtern lässt.
Architektur
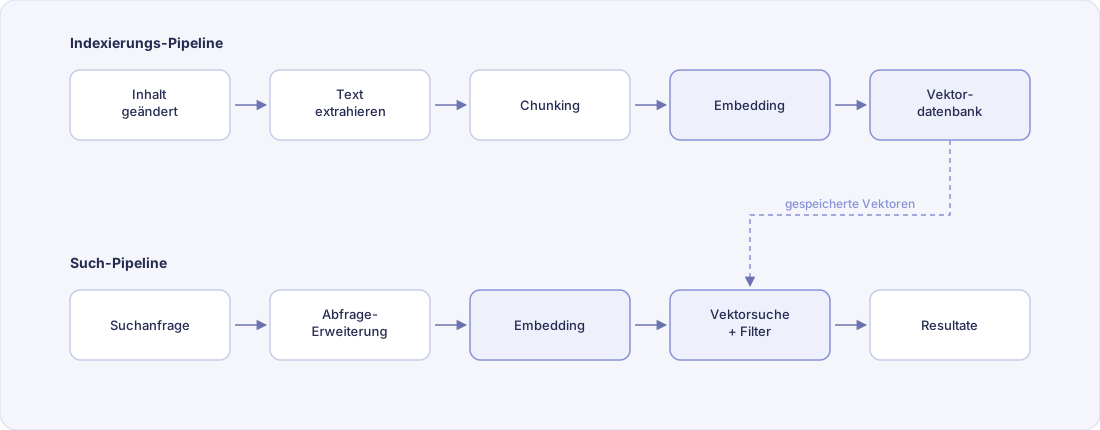
Konzeptionell haben wir zwischen einer Indexierungs- und einer Such-Pipeline unterschieden. Diese Trennung war zentral, da beide Prozesse unterschiedliche Anforderungen haben: Die Indexierung soll asynchron im Hintergrund laufen und beliebig skalieren können, während die Suche auf möglichst tiefe Latenz ausgelegt sein muss.
Indexierungs-Pipeline
Sobald sich ein Inhalt ändert, wird der relevante Text extrahiert, in Chunks aufgeteilt und über das Embedding-Modell in Vektoren umgewandelt. Diese werden anschliessend zusammen mit Metadaten wie Projekt-ID oder Zugriffsrechten indexiert, bestehende Chunks zum selben Objekt werden dabei gelöscht, um den Index aktuell zu halten. Um auch grössere Mengen an Änderungen gleichzeitig verarbeiten zu können, läuft die Indexierung auf mehrere Arbeitsprozesse verteilt.
Such-Pipeline
Bei einer Suchanfrage läuft ein ähnlicher, aber synchroner Prozess ab. Zuerst wird der Benutzerkontext ermittelt, also die Projekte und Berechtigungen der suchenden Person, damit ausschliesslich zugängliche Inhalte gefunden werden. Die Anfrage selbst wird zusätzlich über eine Abfrage-Erweiterung angereichert, bevor sie eingebettet und mit den Filter-Optionen zusammen an die Vektordatenbank gestellt wird. Das Resultat ist eine nach semantischer Relevanz sortierte Liste an Treffern.
Technische Umsetzung
Technologie-Stack
Für den Prototyp haben wir ein eigenständiges Backend mit FastAPI gebaut, das sich als eigener Microservice betreiben lässt. Für die typischen Bausteine semantischer Suchsysteme wie Chunking, Text-Embeddings und Datenextraktion kommt LangChain zum Einsatz, gespeichert werden die Vektoren in Azure Cosmos DB NoSQL, welche Dokumenten- und Vektordatenbank in einem vereint und sich nahtlos in eine bestehende Azure-Infrastruktur integrieren lässt.
Auswahl der Komponenten
Für die einzelnen Komponenten haben wir jeweils mehrere Optionen verglichen. Beim Embedding-Modell fiel die Wahl anhand des Massive Text Embedding Benchmark5 auf text-embedding-3-large von OpenAI, welches unter den evaluierten mehrsprachigen Modellen die beste Retrieval-Performance erzielte. Für die Abfrage-Erweiterung haben wir uns für einen Zero-Shot-Query2Expansion-Ansatz entschieden, bei dem ein Sprachmodell die Suchanfrage vorgängig um passende Stichworte anreichert6. Als Modell dafür kommt Ministral 3B zum Einsatz, das im Vergleich zu den Alternativen den besten Kompromiss aus Kosten und Antwortgeschwindigkeit bot.
Verworfene Erweiterungen
Nicht jede Erweiterung, die wir prototypisch umgesetzt haben, hat es in die finale Architektur geschafft. Eine hybride Suche, welche Vektor- und Volltextsuche über Reciprocal Rank Fusion kombiniert7, lieferte zwar leicht bessere Resultate, benötigte aber teilweise mehrere Sekunden pro Anfrage. Auch ein nachgelagertes Re-Ranking der Resultate mit einem Cross-Encoder-Modell8 konnte die Ergebnisqualität nicht spürbar genug verbessern, um die zusätzliche Latenz zu rechtfertigen. Da eine Suche mit Antwortzeiten von unter einer Sekunde als hartes Ziel definiert war, haben wir uns am Ende für die reine Vektorsuche mit Abfrage-Erweiterung entschieden.
Evaluation
Technische Evaluation mit BEIR
Um die verschiedenen Kombinationen aus Chunking, Embedding-Modell und Erweiterungen objektiv zu vergleichen, haben wir den BEIR-Benchmark verwendet, eine Sammlung von Datensätzen für unterschiedliche Information-Retrieval-Aufgaben9. Bewertet wurde jeweils mit der NDCG@10-Metrik, welche berücksichtigt, wie gut ein System relevante Dokumente ermittelt und wie weit oben es sie einordnet. Als Referenz diente uns die öffentliche BEIR-Bestenliste10. Die finale Kombination aus Vektorsuche, text-embedding-3-large und Abfrage-Erweiterung erzielte über die drei getesteten Datensätze hinweg die besten Werte innerhalb unserer Evaluation und lag damit deutlich näher an den publizierten Bestwerten als die einfache Vektorsuche ohne Erweiterungen.
Evaluation durch Nutzerfeedback
Zusätzlich zur technischen Auswertung haben zehn Testpersonen den Prototyp anhand konkreter Aufgabenstellungen ausprobiert und im Anschluss ein strukturiertes Feedbackformular ausgefüllt. Über alle Testfälle hinweg lag die Korrektheit der Lösungen bei über 93 Prozent. Die Antwortzeiten wurden mehrheitlich mit den höchsten Werten bewertet, ebenso die Relevanz der Suchergebnisse. Im direkten Vergleich zur bisherigen Suche fiel das Urteil damit deutlich zugunsten der semantischen Suche aus, auch wenn einige Testpersonen zunächst etwas Zeit brauchten, um sich von der gewohnten Stichwortsuche auf die neue, kontextbewusste Suche umzustellen.
Fazit und Ausblick
Die Arbeit zeigt, dass sich eine performante und kontextbewusste semantische Suche mit vertretbarem Aufwand realisieren lässt, die einer klassischen Stichwortsuche in Trefferqualität und Nutzererlebnis deutlich überlegen ist. Ein spannender nächster Schritt wäre die Kombination mit Retrieval-Augmented Generation, bei der ein Sprachmodell basierend auf den gefundenen Resultaten direkt Antworten oder Zusammenfassungen generiert, statt nur eine Trefferliste zurückzugeben11.
Quellen
- [1] IBM: What is Vector Embedding?
- [2] IBM: What Is A Vector Database?
- [3] Pinecone: Chunking Strategies for LLM Applications
- [4] Chroma Research: Evaluating Chunking Strategies for Retrieval
- [5] Muennighoff et al.: MTEB: Massive Text Embedding Benchmark
- [6] Jagerman et al.: Query Expansion by Prompting Large Language Models
- [7] Cormack, Clarke & Buettcher: Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods
- [8] Zhang et al.: mGTE: Generalized Long-Context Text Representation and Reranking Models for Multilingual Text Retrieval
- [9] Thakur et al.: BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models
- [10] Kamalloo et al.: Resources for Brewing BEIR: Reproducible Reference Models and an Official Leaderboard
- [11] Lewis et al.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks